검색 시딩에 CSLS를 이식한 뒤: 10만 라벨에서 드러난 cutoff 회귀와 raw-cosine floor
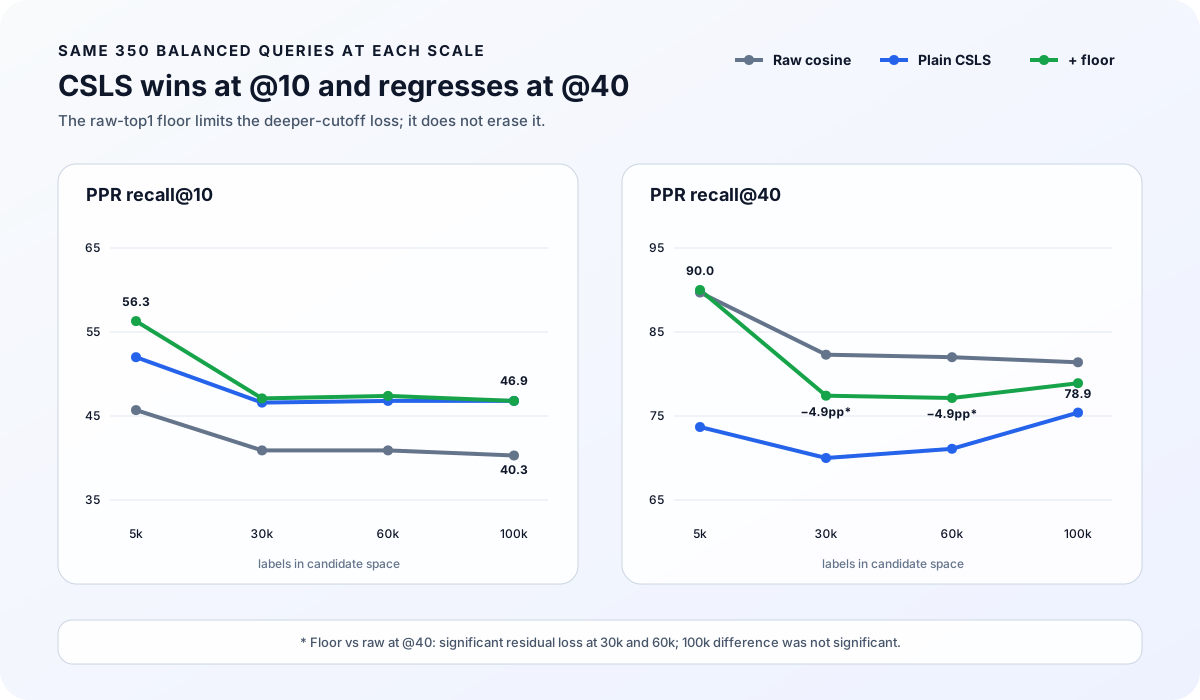
6개 픽스처×3회에서 dense seeding recall@10은 77.5→97.0이었습니다. 그러나 균형 질의 350개를 10만 라벨까지 확장하자 순수 CSLS는 @10을 높이고 @40을 낮췄습니다. raw-top1 floor가 손실을 줄였지만 3만·6만에는 −4.9pp의 유의한 잔여 회귀가 남았습니다.
- dense seeding recall@10 · 6개 픽스처×3회
- 77.5 → 97.0
- 100k floor의 @10 / @40 · raw는 40.3 / 81.4 · n=350
- 46.9 / 78.9
질문: 여러 질의에 두루 가까운 임베딩 후보가 semantic seed를 점유할 때, 국소 밀도 보정으로 정답을 되찾으면서 더 깊은 cutoff의 손실도 막을 수 있는가?
관찰: 6개 픽스처×3회에서 adapted CSLS는 dense seeding recall@10을 77.5→97.0으로 높였다. 그러나 5천~10만 라벨에서는 @10을 높이는 동시에 @40을 낮췄고, raw-cosine 1위 floor 뒤에도 3만·6만에서 −4.9pp의 유의한 잔여 손실이 남았다.
결정: CSLS를 무조건 우월한 교체가 아니라 cutoff 의존 정책으로 취급한다. raw floor·샘플 상한·규모 가드를 유지하되, “모든 규모에서 무손실” 주장은 철회하고 자연 질의 분포에서 재검증한다.
밀집한 표와 카탈로그에서 semantic seed 상위권이 서로 비슷한 항목으로 채워지고 정답 엔티티가 잘리는 현상이 있었습니다. 문제는 최종 reranking이 아니라 그래프 확산이 시작되기 전 후보 생성 단계였습니다. 정답이 후보에 없으면 뒤의 모델이나 랭커는 되살릴 수 없습니다.
이 연구는 교차언어 임베딩의 CSLS를 GraphRAG 시딩에 이식한 뒤, 작은 성공을 10만 라벨까지 확장해 다시 깨뜨린 기록입니다.
1. 진단: “질의에 가깝다”와 “모든 것에 가깝다”
50행 표에서 여러 행 라벨의 임베딩이 거의 겹치자 임의의 닮은꼴이 semantic top-k를 채웠습니다. 정답 triple은 그래프에 있었지만 seed에서 밀려 PPR 뒤에도 top 10 밖에 남았습니다. 이 패턴은 고차원에서 일부 벡터가 많은 질의의 최근접 이웃이 되는 hubness와 일치합니다.
다만 이 연구는 k-occurrence 왜도 같은 hubness 통계를 직접 측정하지 않았습니다. 정확한 표현은 hubness와 일치하는 국소 밀도 실패를 관찰했고, 밀도 보정 개입이 그 실패를 줄였다는 것입니다.
먼저 두 가지 직관을 정량적으로 시험했습니다.
| 개입 | 결과 | 기각 이유 |
|---|---|---|
| top-1과 top-k margin이 작으면 semantic off | 효과 없음 | 실패 표의 margin이 산문보다 작지 않아 gate가 발동하지 않음 |
| 후보 간 평균 유사도가 높으면 semantic off | 한 표 17→83, 다른 표 50→50 | 실제 표 0.61과 semantic이 필요한 산문 0.57이 겹침 |
보존 기록은 이 두 대안만 수치로 검증합니다. MMR 등을 포함해 “세 대안을 모두 기각했다”고 확장하지 않습니다.
2. 다른 분야의 보정을 시딩에 맞게 바꾸다
CSLS는 교차언어 단어 임베딩에서 hub 후보를 억제하기 위해 제안됐습니다. 후보 엔티티 e가 주변 이웃과 평균적으로 얼마나 가까운지 r_k(e)를 구하고, 질의 유사도에서 그 국소 인기도를 뺍니다.
Consilience의 시딩 순위에는 다음 adapted score를 사용했습니다.
score(q,e) = 2 · cosine(q,e) − r_k(e)
원래 대칭식의 r_k(q)는 모든 후보에 같은 상수라 한 질의 안의 순위를 바꾸지 않으므로 생략했습니다. 이 계산은 이미 저장된 임베딩 위에서 수행돼 질의당 API 호출은 늘지 않습니다. 대신 임베딩 generation마다 국소 밀도를 계산하는 CPU·메모리 비용은 발생합니다.
3. 작은 픽스처: 큰 이득과 이미 보였던 경계
6개 단일 문서 케이스를 매번 재추출해 3회 평균했습니다. 이 초기 A/B는 시딩 로직을 eval 쪽에 재구성한 하니스이므로 프로덕션 함수의 완전한 직접 호출로 보지 않습니다.
| 조건 | recall@10 |
|---|---|
| lexical only | 85.2 |
| raw dense seeding | 77.5 |
| dense + adapted CSLS | 97.0 |
이득은 밀집 표에서 컸습니다. 균일 50행 표는 raw 22→CSLS 100, 실제 이름을 가진 32행 표는 50→100이었습니다. 그러나 모든 케이스가 무손실은 아니었습니다. 영어 항공우주 산문은 raw 100→CSLS 89였고, 작은 표는 93으로 동률이었습니다. “산문에는 회귀가 없었다”는 일반화는 하지 않습니다.
6개 문서를 한 워크스페이스의 263개 엔티티로 합친 조건에서도 평균 recall@10은 75.8→96.0이었습니다. 별도의 context-only QA 31문항에서는 3회 매크로 답 정확도가 89→97로 움직였습니다. 둘 다 제한된 내부 픽스처이며 외부 QA 벤치마크가 아닙니다.
작은 실험은 CSLS를 채택할 근거가 아니라 대규모 반증 실험을 할 이유를 만들었습니다.
4. 5천~10만 라벨: cutoff에 따라 승자가 바뀌었다
실제 그래프 라벨 23,859개를 코어로 두고 Wikipedia 제목·EDGAR 기업명·통제 클러스터를 더해 5천, 3만, 6만, 10만 라벨의 사다리를 만들었습니다. 각 규모에서 동일한 350개 질의를 사용했습니다. 계층은 isolated 100, organic-dense 100, injected-cluster 100, cross-language 50으로 균형 배치돼 자연 트래픽 비율은 아닙니다.
| labels | @10 raw / CSLS / floor | @40 raw / CSLS / floor |
|---|---|---|
| 5k | 45.7 / 52.0 / 56.3 | 89.7 / 73.7 / 90.0 |
| 30k | 40.9 / 46.6 / 47.1 | 82.3 / 70.0 / 77.4 |
| 60k | 40.9 / 46.9 / 47.4 | 82.0 / 71.1 / 77.1 |
| 100k | 40.3 / 46.9 / 46.9 | 81.4 / 75.4 / 78.9 |
순수 CSLS는 @10에서 모든 규모의 raw를 앞섰지만 @40에서는 모두 뒤졌습니다. 원인은 organic-dense 계층이었습니다. 타깃 자신이 밀집한 제품군이나 표 행의 구성원일 때, 보정이 클러스터 전체를 누르면서 타깃 중위 순위를 21→854로 밀었습니다. 10개만 보면 드러나지 않지만 제품 경로는 약 40개 후보를 소비하므로 실제 손실입니다.
이 결과는 “작은 성공이 규모에서도 재현됐다”보다 더 정확한 결론을 줍니다. 방향은 cutoff에 의존했고, 단일 headline metric이 반대편 손실을 가렸습니다.
5. raw-top1 floor는 손실을 줄였지만 없애지 않았다
수정은 raw cosine 1위 후보에게 CSLS 강등과 무관하게 한 자리와 원래 가중치를 보장하는 floor였습니다. @10 이득은 유지하거나 늘었고 @40 손실은 크게 줄었습니다.
그러나 floor를 Pareto-dominant라고 부를 수는 없습니다.
- 30k @40: 77.4 vs raw 82.3, −4.9pp, 유의.
- 60k @40: 77.1 vs raw 82.0, −4.9pp, 유의.
- 100k @40: 78.9 vs raw 81.4, 집계 원수치 −2.6pp, 비유의.
raw 2~8위인 밀집 타깃은 한 자리 floor가 구하지 못합니다. floor 폭을 늘리면 억제했던 닮은꼴을 다시 상위에 들이는 트레이드오프가 생깁니다. 현재 구현은 floor를 유지하지만, 의사결정은 “무손실 출하”가 아니라 상위 10 이득을 보존하며 더 깊은 손실을 제한한 조건부 정책으로 다시 분류합니다.
6. 더 정확한 밀도 추정이 더 나빴다
10만 라벨에서 1,024개 stride sample로 계산한 CSLS는 @10 46.9였고, sample 4,096은 44.9, 전수 이웃을 사용한 exact는 38.9였습니다. exact는 밀도 추정의 오라클이지 relevance의 오라클이 아닙니다.
샘플은 실제 이웃을 일부 놓쳐 (r_k)를 낮게 추정하고 강등을 완화합니다. 이 편향이 결과적으로 soft temperature처럼 작동했습니다. 따라서 SAMPLE_CAP=1,024를 고정하고 “정확도를 높인다”는 명목으로 ANN이나 exact 계산을 넣지 않도록 가드를 남겼습니다.
10만 라벨의 국소 밀도 계산은 같은 환경에서 직렬 6.9초, Rayon 병렬 647ms였습니다. 임베딩 상주량은 약 300MB급이었습니다. 방법 자체의 추가 API 호출은 0이지만, 규모 실험 구축에는 약 $2.6의 API 비용과 CPU·메모리가 들었습니다. 측정은 10만까지이며 20만 cap은 성능 외삽이지 품질 검증 범위가 아닙니다.
7. 한계와 현재 판단
- 350개 질의는 네 계층을 인위적으로 균형 배치했습니다. 전체 평균을 자연 사용자 기대값으로 읽을 수 없습니다.
- 증강 라벨의 그래프 토폴로지는 합성이며, 실제 토폴로지는 코어 41개 그래프에만 있습니다.
- 초기 6픽스처와 규모 하니스의 충실도가 다르고, 모든 조건이 같은 프로덕션 함수를 직접 호출한 것은 아닙니다.
- paired bootstrap 10,000회는 보존 분석 코드에서 확인되지만 McNemar 구현은 확인되지 않아 보고하지 않습니다.
- @10, @40과 QA 정확도는 서로 다른 결과변수입니다. 하나의 개선으로 나머지를 대체하지 않습니다.
- 현재 정책은 raw floor와 샘플·규모 가드를 유지하되, 자연 질의 분포와 더 깊은 cutoff에서 독립 재실행하기 전에는 일반적 우월성을 주장하지 않는 것입니다.
재현성과 증거 경계
| 항목 | 보존 상태 |
|---|---|
| 최초 측정 | 2026년 6월 28일; 6픽스처×3회, 약 300엔티티 |
| 규모 검증 | 2026년 7월 16일; 5k/30k/60k/100k 라벨, 규모별 동일한 균형 질의 350개 |
| 원기록 | docs/details/graphrag-seeding-csls.md, csls-scale-eval-2026-07.md |
| 구현 | src-tauri/src/rdf/ppr.rs; adapted CSLS, raw-top1 floor, sample cap |
| 보존 산출물 | 집계 표와 재생성 스크립트. 1.4GB 원시 corpus·graph snapshot·JSONL은 2026-07-16 삭제 |
| 비트 단위 재현 | 불가. 당시 앱 DB, Wikipedia latest, 비결정적 질의 생성과 hash-map 순회 상태에 의존 |
| 현재 주장 상태 | fixture @10 이득과 scale cutoff tradeoff 유지; “전 규모 무손실”, “floor의 완전한 parity” 주장은 철회 |
무엇을 측정한 것인가
- Consilience
지식그래프를 바탕으로 코딩·디자인·질의를 수행하는 범용 AI 에이전트입니다. 파견 엔지니어 없이 문서에서 온톨로지를 구축하고 관리합니다.