연구
-
벤치마크
범용 VLM 문서 파싱 파이프라인: DP-Bench TEDS·TEDS-S 최고점 후보
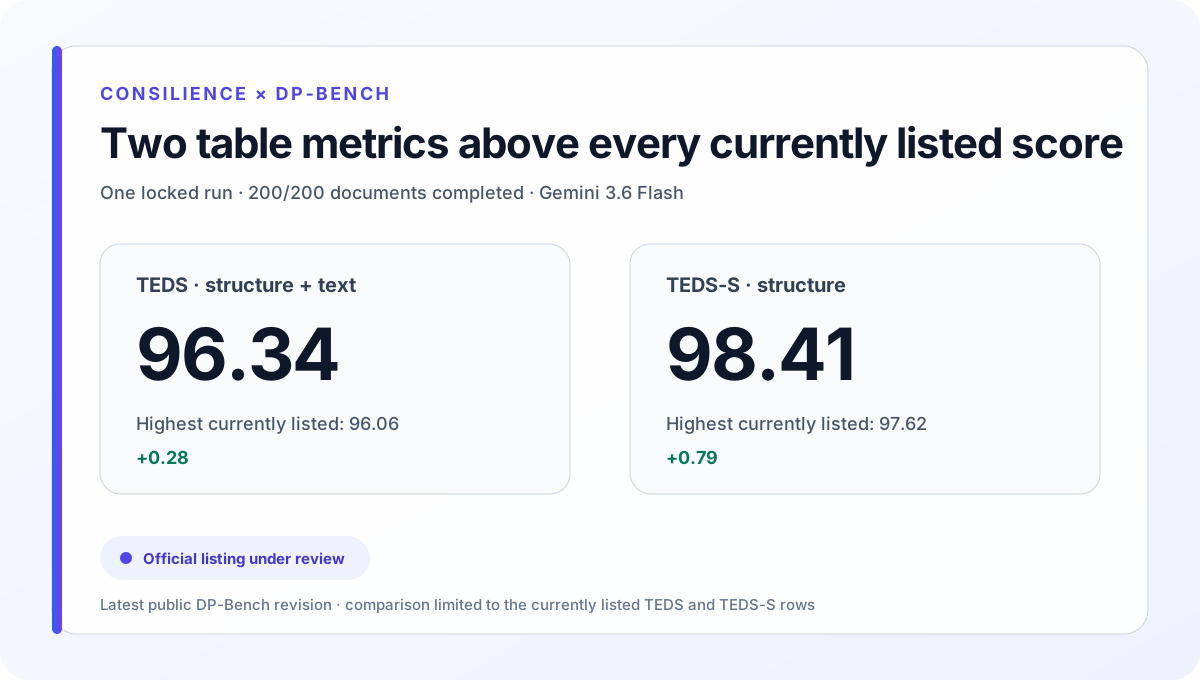
Gemini 3.6 Flash 기반 Consilience 문서 파싱 파이프라인의 단일 고정 실행이 최신 공개 DP-Bench 200문서에서 TEDS 96.34와 TEDS-S 98.41을 기록했습니다. 현재 등재 최고값을 각각 0.28점, 0.79점 넘었고 공식 등재를 요청했습니다.
- 96.34 / 98.41 TEDS / TEDS-S · 단일 고정 실행 · n=200 · Discussion #6 등재 검토 중
- 200 / 200 전체 문서 성공 · 문서별 출력 선택이나 수동 수정 없음
-
기법
Consilience EngramRAG: 장기 인간–AI 작업을 위한 문서 기반 온톨로지 메모리
사람이 수정하는 Markdown과 기계가 탐색하는 온톨로지를 하나의 지속형 메모리 생명주기로 결합했습니다. 모델 고정 애블레이션, 실제 볼트 평가, 재현 실패와 한계를 통해 모델 외부 구조의 기여를 분리합니다.
- 14/21 → 18/21 같은 모델·과제·에이전트에서 그래프 구조만 추가한 코드 위치 탐색
- +30.7 ~ +38.7pp 두 실제 볼트의 recall@10, 전체 융합과 키워드 전용의 차이
-
기법
Veridion 오픈셋 보정: 규모에 따라 판정선을 바꾸고, 측정할 수 없으면 멈추기
캐릭터 검색을 고정 코사인 임계값이 아닌 1:N 오픈셋 식별 문제로 다뤘습니다. 갤러리 규모와 입력 리전 수에서 오탐 예산을 역산하고, 경험적 분포가 요구 수준을 측정하지 못하면 판정을 보류합니다. whole-frame과 crop을 분리 보정하고 불균형 갤러리는 round-robin으로 병합합니다.
뤼튼테크놀로지스 R&D · 요구사항·아키텍처·개발 단독 수행
- 1:N · FPIR 판정선은 모델 상수가 아니라 갤러리·리전 수·검토 예산의 함수
- ABSTAIN 경험적 오탐 꼬리의 측정 해상도 밖에서는 외삽하지 않고 판정 보류
-
기법
되감기 범위의 반사실 검증: 파일 밖 그래프 삭제를 막다
가장 오래된 라이브 체크포인트에 구버전 알고리즘을 읽기 전용으로 적용하자 159,506쿼드 중 102,020개와 앵커 턴이 건드리지 않은 1,057문서의 그래프가 제거될 것으로 계산됐습니다. 실제 사고가 아니라 반사실 replay이며, 수정은 전체 그래프 교체를 touched-document 범위로 제한했습니다.
- 102,020 / 159,506 구버전이 제거했을 쿼드 · 라이브 상태 반사실 · 실제 삭제 아님
- 0 / 1,057 영향 문서 중 앵커 턴이 실제로 건드린 문서
-
기법
통제군과 증거 등급으로 수행한 결함 감사
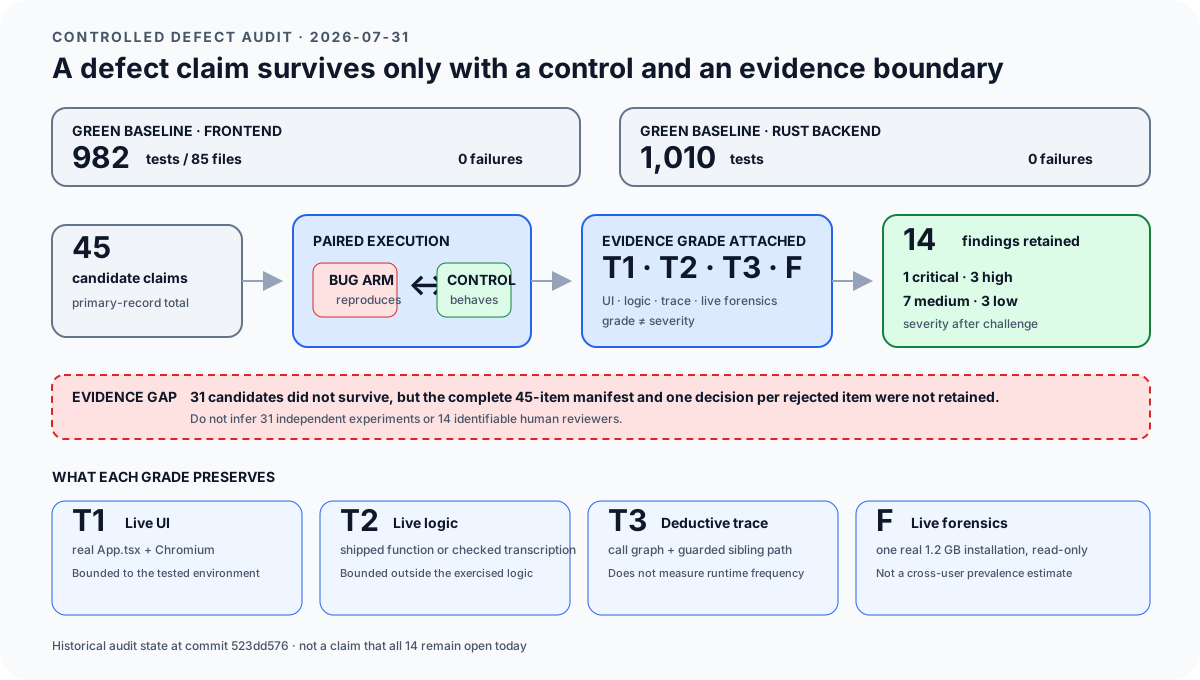
녹색 기준선 위에서 버그 조건과 정상 조건을 쌍으로 실행하고, UI·로직·연역·라이브 포렌식의 증거 등급을 붙였습니다. 감사 스냅샷에는 재현 결함 14개가 열거돼 있지만 45개 전체 후보 원장과 개별 반증 로그는 보존되지 않아, 45→14를 완전 재현 가능한 funnel로 주장하지 않습니다.
- 14 findings 감사 스냅샷에 개별 열거 · 45개 전체 후보 원장은 미보존
- 0 failures 감사 전 기준선 · 프런트엔드 982 / 백엔드 1,010 테스트
-
기법
기본 모델 교체가 드러낸 문서 언어 정책의 공백과 하니스 감사가 남긴 한계
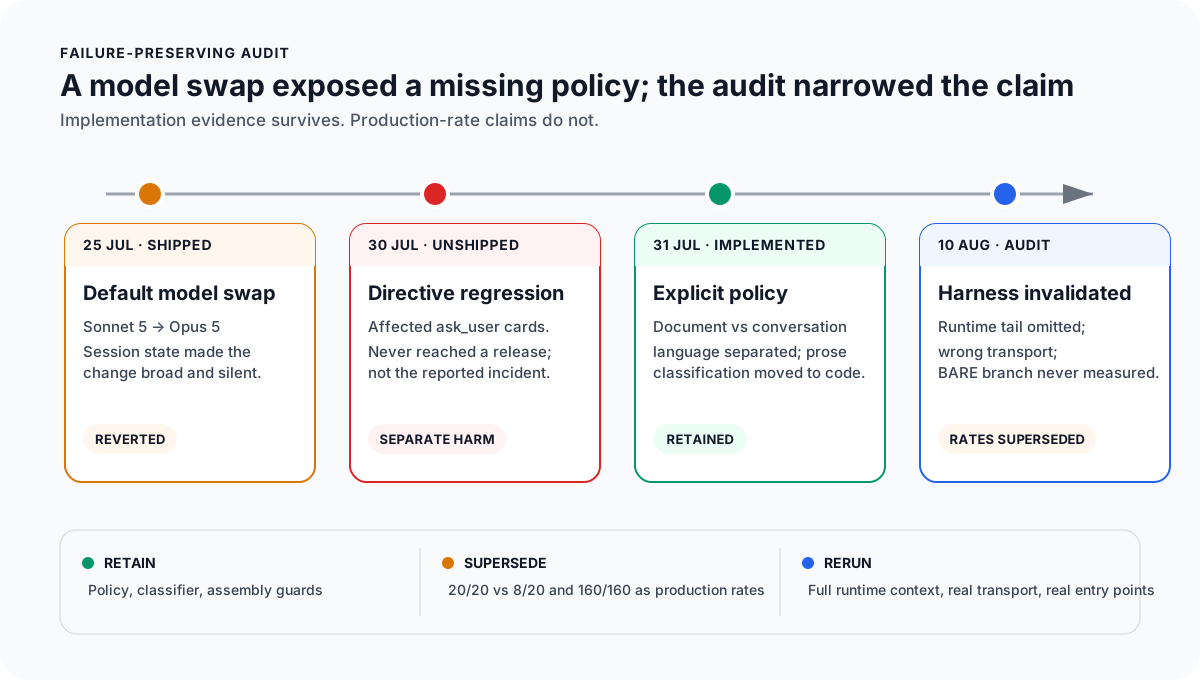
7월 합성 하니스는 두 모델의 언어 선택 차이를 기록했고, 문서 언어와 대화 언어를 분리하는 정책을 만들었습니다. 그러나 8월 10일 감사에서 런타임 프롬프트 꼬리 누락, BARE 분기 미측정, 잘못된 전송 경로가 발견돼 생산 효과 수치와 160/160 주장을 철회했습니다.
- 3 fidelity breaks runtime tail 누락 · BARE 미측정 · 프로덕션과 다른 transport
- Superseded 역사적 합성 하니스의 생산 인과·수정 후 비율 철회 · 충실한 재실행 필요
-
기법
더 촘촘한 추출은 관계를 늘렸지만 검색 이득은 검출되지 않았다
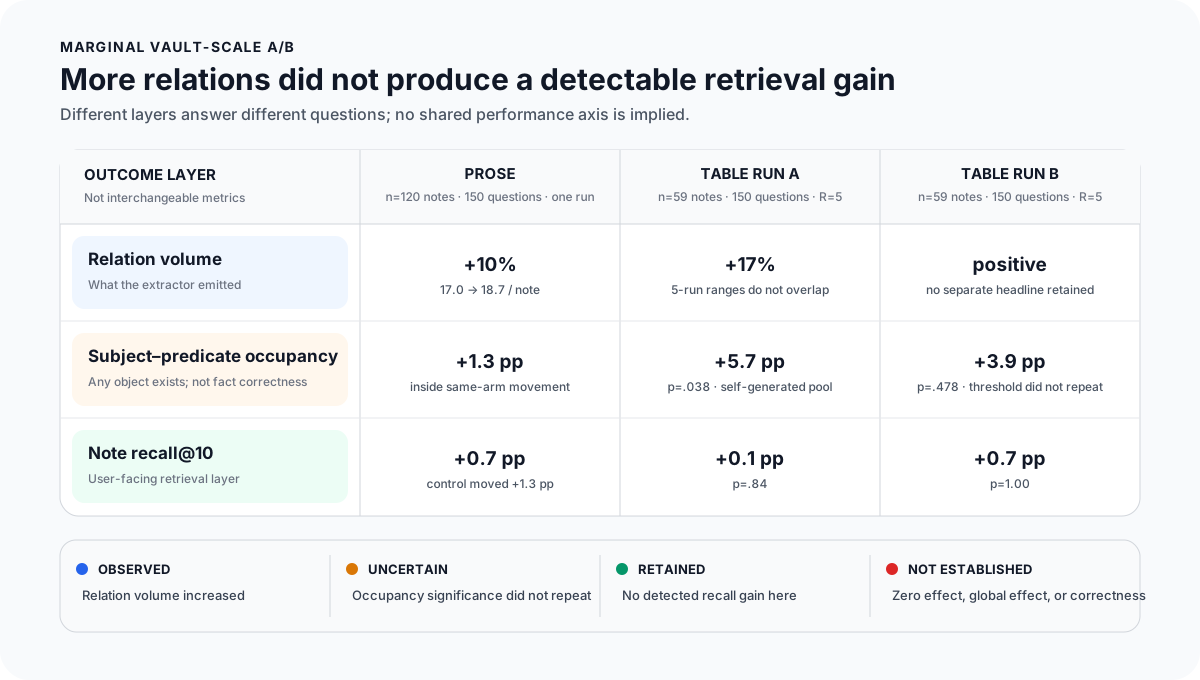
2,810문서 그래프에서 선택한 120개 산문과 59개 표 노트의 부분그래프만 바꿨습니다. 관계 수는 10–17% 늘었지만 노트 recall@10 차이는 산문 +0.7pp, 표 +0.1/+0.7pp였고 하니스 변동을 넘어선 이득을 검출하지 못했습니다. 전역 효과가 0이라는 뜻은 아닙니다.
- +0.7pp 산문 note recall@10 관측 차이 · 120/2,810 부분그래프 개입
- +0.1 / +0.7pp 표 note recall@10 · 5회 반복 두 실행 · 관계 수 +17%
-
기법
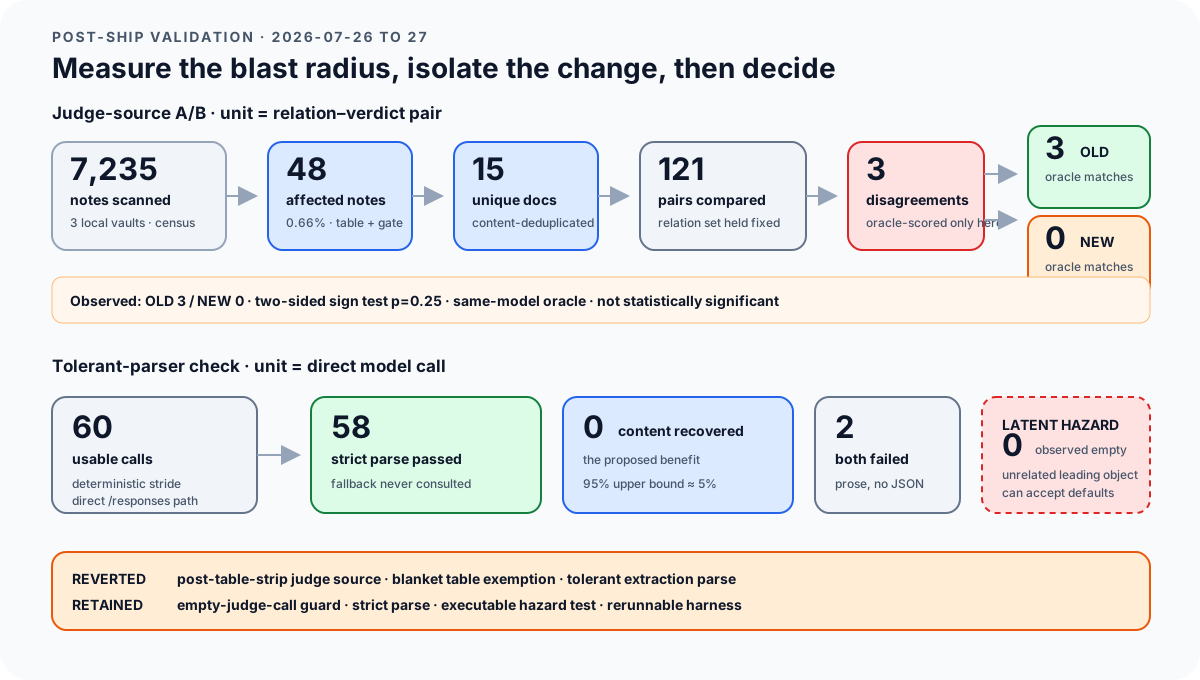
배포 후 검증: 판정기 원문 변경과 관대한 파서를 되돌린 근거
같은 관계 121쌍에서 판정기 원문만 바꾼 A/B의 불일치 3건은 모두 기존 구현이 모델 오라클과 일치했습니다. 관대한 파서는 직접 호출 60건에서 추가 복구가 0건이었습니다. 두 변경을 되돌리고, 표 관계 면제는 전체 로그 영향 9/3,215를 근거로 보류했습니다.
- OLD 3 · NEW 0 121쌍·불일치 3건·동일 모델 3회 오라클·부호검정 p=.25
- 0 / 60 관대한 파서의 추가 content 복구 · 직접 /responses · 95% 상한 약 5%
-
벤치마크
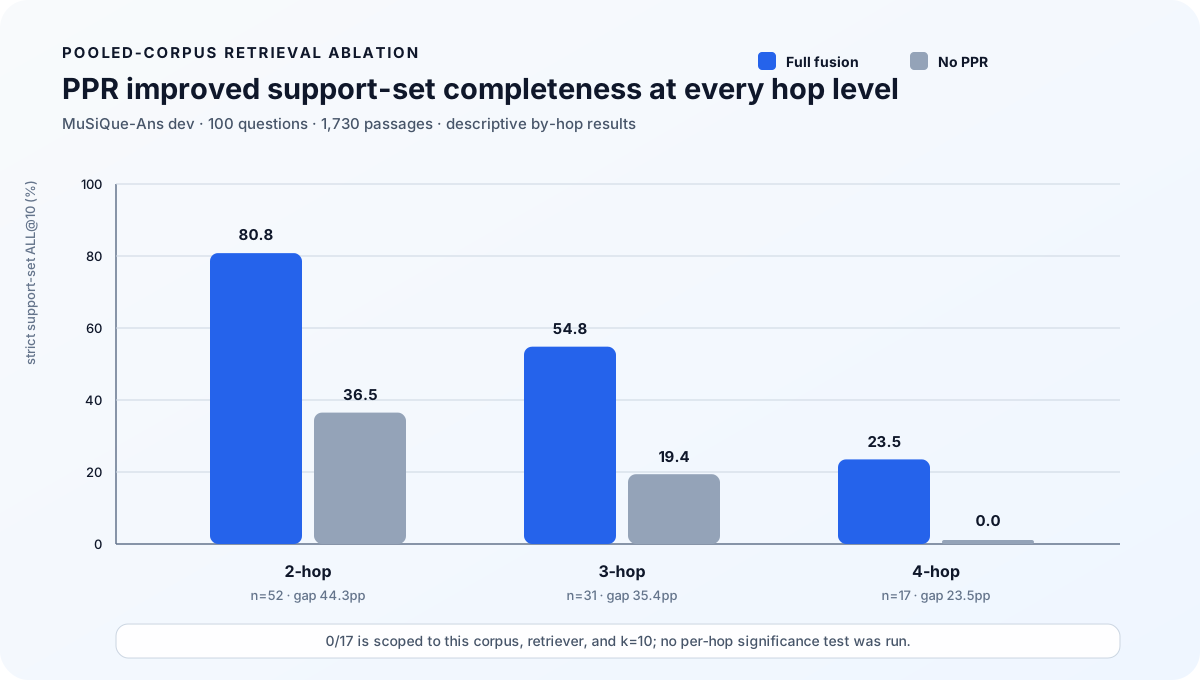
MuSiQue pooled-corpus 애블레이션: PPR 그래프 레그와 고정 융합 가중치의 한계
100문항·1,730문단의 내부 검색 파일럿에서 strict support-set ALL@10은 전체 융합 63%, PPR 제거 25%, 키워드 전용 23%였습니다. 4홉의 23.5% 대 0/17은 이 설정의 기술통계로 한정하고, 코퍼스에 따라 BM25 가중치의 방향이 뒤집힌 결과까지 보고합니다.
- 63.0 vs 25.0 ALL@10 · 전체 융합 vs PPR 제거 · n=100
- 23.5 vs 0.0 4홉 ALL@10 · n=17 · 홉별 유의성 검정 없음
-
기법
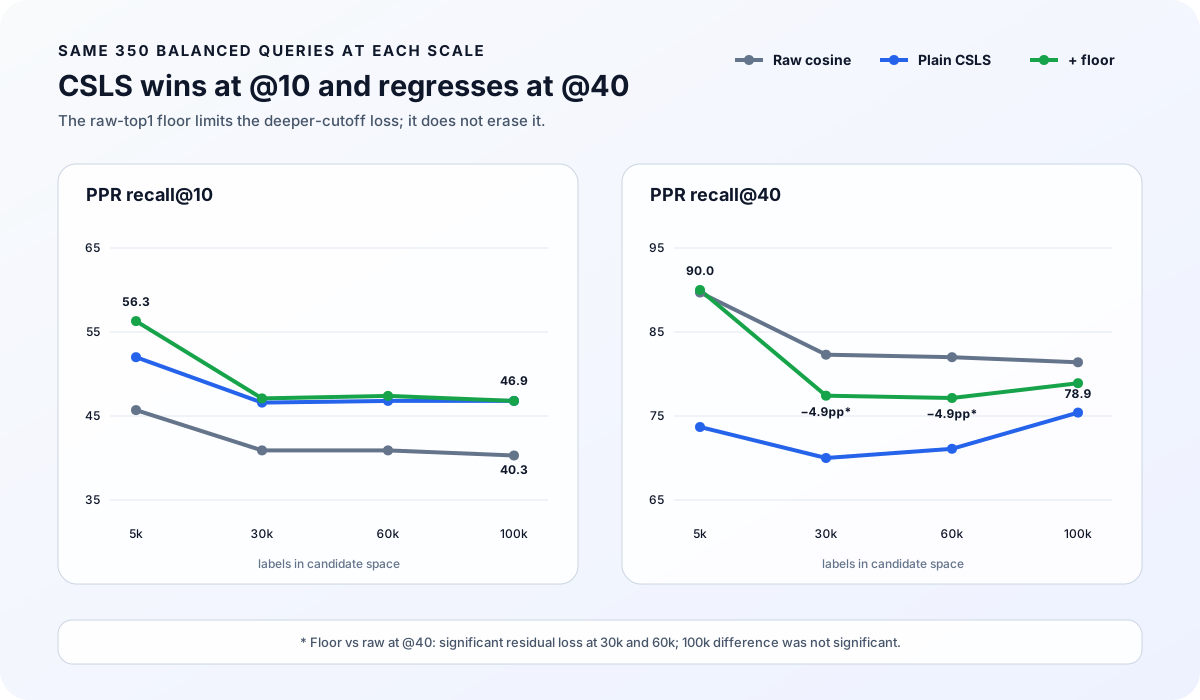
검색 시딩에 CSLS를 이식한 뒤: 10만 라벨에서 드러난 cutoff 회귀와 raw-cosine floor
6개 픽스처×3회에서 dense seeding recall@10은 77.5→97.0이었습니다. 그러나 균형 질의 350개를 10만 라벨까지 확장하자 순수 CSLS는 @10을 높이고 @40을 낮췄습니다. raw-top1 floor가 손실을 줄였지만 3만·6만에는 −4.9pp의 유의한 잔여 회귀가 남았습니다.
- 77.5 → 97.0 dense seeding recall@10 · 6개 픽스처×3회
- 46.9 / 78.9 100k floor의 @10 / @40 · raw는 40.3 / 81.4 · n=350
-
벤치마크
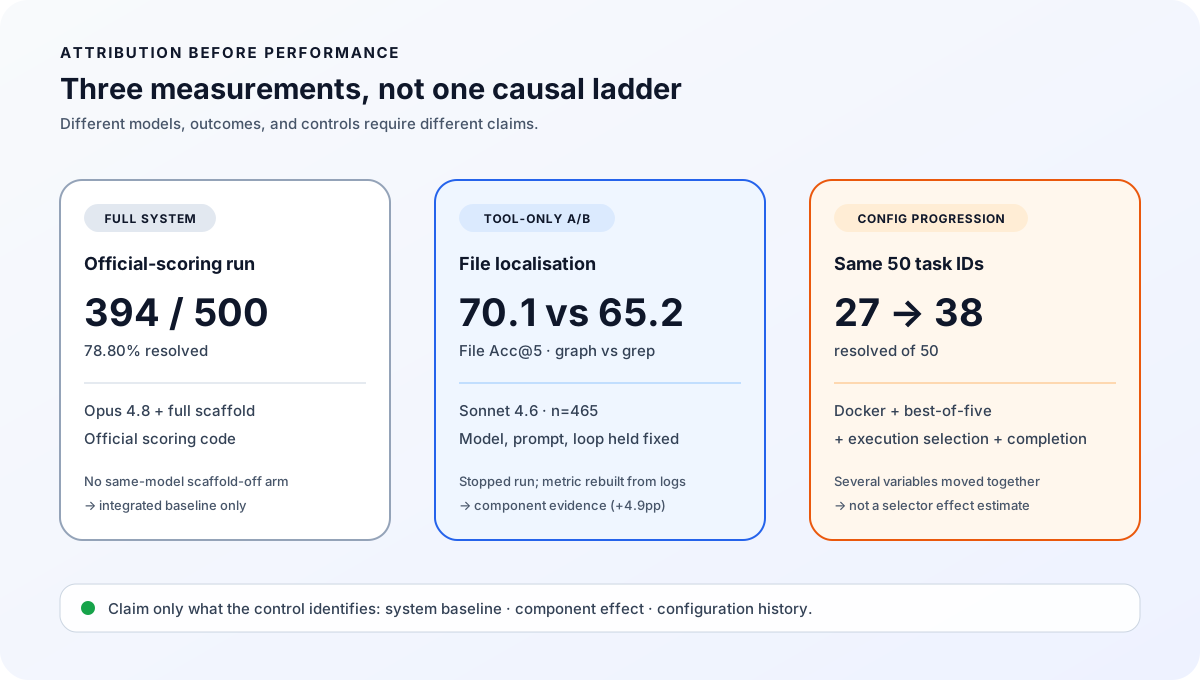
SWE-bench Verified 전수 실행: 394/500과 귀속의 한계
Opus 4.8과 전체 스캐폴드를 합친 시스템은 공식 채점 코드에서 394/500을 해결했습니다. 동일 모델의 scaffold-off 대조군이 없음을 먼저 밝히고, 별도의 Sonnet 4.6 도구 A/B에서 코드그래프 70.1% 대 grep 65.2% File Acc@5를 구성요소 증거로 분리합니다.
- 394 / 500 78.80% · 공식 채점 코드 · 모델+스캐폴드 통합 결과
- 70.1 vs 65.2 File Acc@5 · graph vs grep · Sonnet 4.6 · 중단 실행 n=465
-
기법
Xhadow: 자기 목소리를 기준선으로 삼는 음향 근거 발음 코칭
학습자의 목소리를 목표 언어로 복제한 레퍼런스와 실제 발화를 비교합니다. 브라우저 DSP, 음소 평가, 단어 앵커 분할 DTW와 WSOLA로 근거를 계산하고, 측정된 차이를 혀·턱·입술의 행동 지시로 번역합니다.
- FFT · formants 브라우저 DSP: F0·스펙트럼 피크·유성성·음색 분석
- DTW · WSOLA 단어 앵커 분할 정렬과 피치 보존 재합성