더 촘촘한 추출은 관계를 늘렸지만 검색 이득은 검출되지 않았다
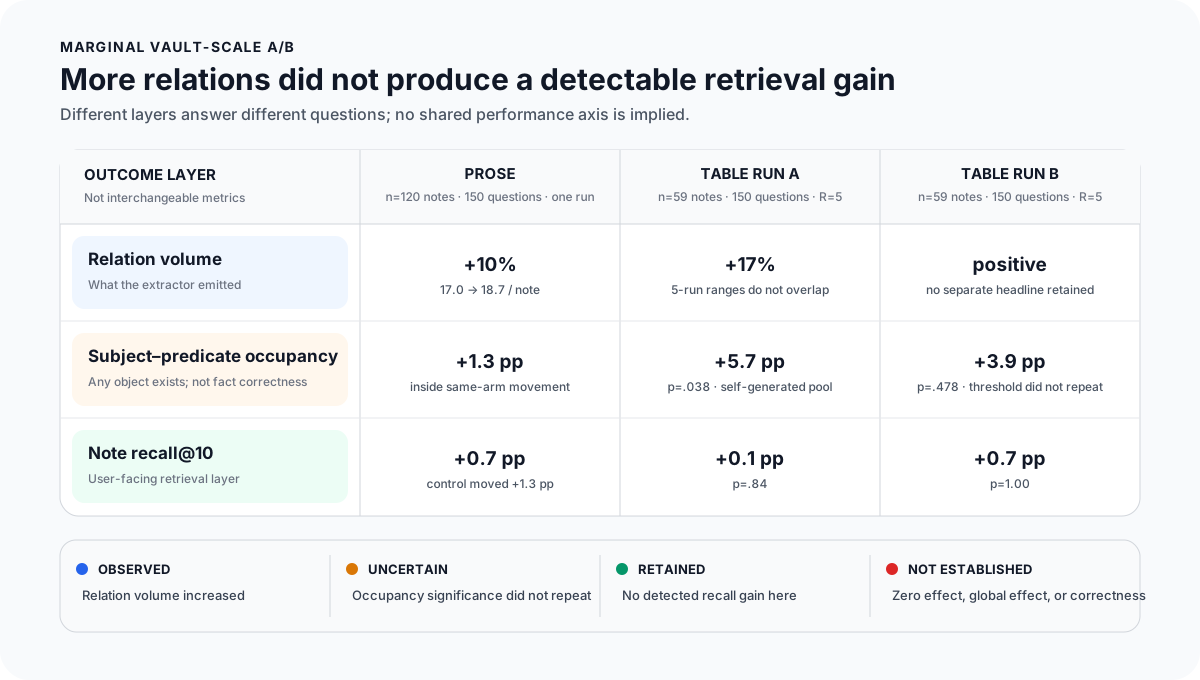
2,810문서 그래프에서 선택한 120개 산문과 59개 표 노트의 부분그래프만 바꿨습니다. 관계 수는 10–17% 늘었지만 노트 recall@10 차이는 산문 +0.7pp, 표 +0.1/+0.7pp였고 하니스 변동을 넘어선 이득을 검출하지 못했습니다. 전역 효과가 0이라는 뜻은 아닙니다.
- 산문 note recall@10 관측 차이 · 120/2,810 부분그래프 개입
- +0.7pp
- 표 note recall@10 · 5회 반복 두 실행 · 관계 수 +17%
- +0.1 / +0.7pp
질문: 더 촘촘한 관계 추출이 큰 볼트에서 노트 검색을 실제로 개선하는가?
관찰: 관계 수는 산문 n=120노트에서 10%, 표 n=59노트·R=5에서 17% 늘었지만 recall@10 차이는 산문 +0.7pp와 표 +0.1/+0.7pp로, 이 하니스에서 검출 가능한 이득이 없었습니다.
결정: 전역 효과가 0이라고 선언하지 않고 설정은 유지하되, 동일-arm 대조·반복·실패 보존·외부 골드 없이는 개선 수치를 인용하지 않습니다.
1. 픽스처의 60%→97%가 답하지 못한 질문
촘촘한 추출을 전면 적용한 초기 근거는 답변 정확도 60%→97% · 소수 픽스처·단일 문서 그래프·3회 평균이었습니다. 프롬프트 교체와 엔티티·관계 cap 변경도 섞여 있었습니다. 문서가 하나면 검색 경쟁과 순위 컷오프가 거의 없으므로, 이 수치를 볼트 규모의 검색 효과로 일반화할 수 없습니다.
새 실험은 같은 지표의 단순 재현이 아닙니다. 2,810문서 그래프 안에서 선택한 부분그래프만 바꿀 때 노트 recall@10이 얼마나 움직이는가를 물었습니다. 따라서 60%→97%가 “재현 실패했다”기보다, 더 큰 규모에서 다른 결과변수를 측정해 적용 범위를 좁힌 기록입니다.
2. 한계효과를 분리한 설계와 실패 보존
| 설계 항목 | 조건 |
|---|---|
| 코퍼스 | Market 볼트 · 디스크 3,002노트 · 그래프 경로 보유 2,810문서 · 2026-07-30 export |
| 산문 처치 | 표본 120노트의 부분그래프만 교체 · 나머지 2,690문서는 양팔 동일 · Sonnet 5 |
| 산문 평가 | n=150문제 · arm당 174청크 · 단일 실행 + 동일-arm 독립 대조 |
| 표 처치 | 표 8행 이상인 59노트 · arm당 106청크 · 각 arm R=5 독립 추출 |
| 문제 구성 | 모든 arm·replicate 출력의 합집합에서 n=150문제를 시드 샘플링 |
양팔 합집합으로 문제를 만든 이유는 한 arm이 자기 출력만으로 시험지를 만들어 구조적 우위를 얻는 것을 막기 위해서입니다. 동일-arm 대조는 프롬프트를 바꾸지 않아도 추출이 얼마나 흔들리는지 보여줍니다.
하니스도 결과의 일부입니다. 첫 시도에서는 인증 경로가 틀려 48/48청크 · 양팔 전체가 실패했는데, 오류를 삼킨 결과 “관계 0 대 0”이라는 그럴듯한 null이 나왔습니다. 이후 첫 오류를 보존하고 전체 청크의 20% 초과 실패면 실행을 중단하도록 src-tauri/src/tagging/qa_eval.rs에 가드를 넣었습니다. 망가진 계기가 만든 대칭 결과를 성공으로 취급하지 않는 것이 이 실험의 가장 재사용 가능한 장치입니다.
3. 관찰된 결과: 관계는 늘고, 검색 이득은 검출되지 않음
산문은 n=120노트·n=150문제·각 arm 1회 조건입니다.
| 산문 지표 | concise→comprehensive | 동일-arm 대조 | 관찰 |
|---|---|---|---|
| 관계/노트 | 17.0→18.7 · +10% | 17.0→17.1 | 추출량 증가는 대조 변동보다 큼 |
| 주어–술어 점유율 | 66.0%→67.3% · +1.3pp | 69.3%→66.0% · −3.3pp | 대조 변동 안 |
| recall@10 | 89.3%→90.0% · +0.7pp | 91.3%→92.7% · +1.3pp | 대조 변동보다 작음 |
표는 n=59노트·n=150문제·각 arm R=5 조건으로 독립 실행을 두 번 했습니다.
| 표 지표 | 실행 A · 검색 전용 | 실행 B · 답변 포함 | 해석 |
|---|---|---|---|
| 관계/노트 | concise 22.4–23.0 대 comprehensive 26.4–27.1 · +17% | 같은 방향, 별도 headline 미기록 | 실행 A의 5회 범위는 비중첩 |
| 주어–술어 점유율 Δ | +5.7pp · p=.038 | +3.9pp · p=.478 | 방향은 같고 임계 유의성은 재현되지 않음 |
| recall@10 Δ | +0.1pp · p=.84 | +0.7pp · p=1.00 | 두 실행 모두 검출된 이득 없음 |
| 답변 문자열 정확도 Δ | 미측정 | +4.4pp · p=.298 · 총 1,500답변 | baseline 5회 폭 7.3pp 안 |
p=.038→.478은 효과가 반대로 바뀌었다는 뜻이 아닙니다. 점추정은 +5.7pp와 +3.9pp · 각 n=150문제·R=5로 두 번 모두 양수입니다. 달라진 것은 임계값 통과 여부입니다. 반대로 recall의 +0.1pp와 +0.7pp · 각 n=150문제·R=5도 효과가 정확히 0임을 증명하지 않습니다. 동등성 마진, 신뢰구간, 사전 검정력 기준이 없으므로 올바른 문장은 “이 하니스에서 검색 이득이 검출되지 않았다”입니다.
표 실행 A의 “590회”는 API 호출 수가 아니라 59노트 × 2arm × 5replicate = 590 note–arm–replicate 추출 단위입니다. 실제 모델 요청은 106청크 × 2arm × 5replicate = 1,060 extraction calls입니다.
4. 지표가 뜻하는 것과 뜻하지 않는 것
기존 글의 “그래프가 주장한 정답 사실”은 구현보다 강한 이름이었습니다. qa_eval.rs의 answerable은 기록된 정답 객체를 비교하지 않고, 해당 주어–술어에 어떤 객체든 하나 이상 있는지만 봅니다. 따라서 이 기록에서는 주어–술어 점유율이라고 부릅니다.
문제 풀도 사람이나 외부 데이터가 만든 진실 집합이 아닙니다. 모든 모델 arm과 replicate가 추출한 관계의 합집합에서 단일 객체를 가진 주어–술어만 남긴 self-generated pool입니다. 촘촘한 arm이 추가하거나 잘못 만든 관계가 스스로 시험 문제에 들어갈 수 있고, precision은 측정하지 않았습니다. +5.7/+3.9pp를 “더 많은 올바른 사실”로 해석할 수 없는 이유입니다.
표 결과는 프로덕션 추정치도 아닙니다. 실제 run_table_pass는 엔티티 표를 먼저 분류해 결정론적 코드로 적재하고, prose 추출 전에 본문에서 제거합니다. 이 하니스는 표 전체를 prose prompt에 보내므로 표 prompt 차이의 상한에 가깝습니다. 같은 주어–술어에 분기별 값이 반복되는 재무 표는 단일 객체 필터에서 대부분 탈락하므로 표 사실도 구조적으로 과소표집됩니다.
별도의 순위 probe에서 top 10 밖의 42건 중 39건이 후보 풀에 있었다는 관찰은 이미 그래프에 있는 사실만 다룹니다. 골드 자체가 그래프에서 오므로 추출되지 않은 사실은 시험에 들어올 수 없습니다. 따라서 이를 “실볼트의 지배적 실패 원인은 추출이 아니라 순위”라는 인과 설명으로 확장하지 않습니다.
5. 결정, 반사실, 다음 실험
관찰: comprehensive prompt는 이 한 볼트의 선택된 노트에서 관계량을 늘렸습니다. 결정: 설정은 유지했습니다. 더 나쁘다는 증거가 없고 다른 경로에서 쓰이는 정보량을 줄일 근거도 없기 때문입니다. 이것은 retrieval 개선이 입증됐다는 뜻이 아닙니다.
측정하지 않은 반사실: 2,810문서 전체를 concise와 comprehensive로 각각 재추출했을 때의 전역 효과입니다. 이번 실험은 120/2,810문서 · 4.3%의 부분그래프만 바꿨고, 나머지 2,690문서는 양팔 모두 기존 comprehensive 상태였습니다. 한 볼트·한 소유자 결과이기도 합니다.
다시 열 조건은 명확합니다. 외부 검증된 객체 수준 골드와 precision, 질문·노트 군집을 반영한 불확실성, 사전에 정한 동등성 마진, 실제 run_table_pass를 포함한 경로, 전수 재추출 또는 사전에 검정력을 정한 반복 수가 필요합니다. 실행 A와 B의 문제 풀도 적격 항목 446개 대 445개에서 각각 다시 샘플됐으므로 두 실행을 사후 단순 합산하지 않습니다.
재현성과 증거 경계
| 증거 | 현재 확인 가능한 것 | 경계 |
|---|---|---|
docs/details/extraction-arms-vault-scale-2026-07-30.md |
설계, 집계값, 비용 $74.37 · 전체 실험군 OpenRouter 실청구액 | Market 원문과 완전한 raw run log는 공개 재현 불가 |
src-tauri/src/tagging/qa_eval.rs::extraction_arms_vault_ab |
arm 정의, pooled pool, 주어–술어 점유율 구현, 실패율 중단 | 외부 truth·precision·cluster-aware interval 없음 |
| 산문 결과 | n=120노트·n=150문제·단일 실행과 동일-arm 대조 | 한계효과이며 원래 60%→97% 답변 지표와 다름 |
| 표 실행 A/B | 각 n=59노트·n=150문제·R=5 | production table path가 아니며 두 run의 문제 표본도 다름 |
| 실패 청크 기록 | 실행 A 1/1,060, 실행 B 7/1,060으로 본문에 별도 기록 | 최종 요약의 1/2,240과 모순; raw log 확인 전 합계 인용 금지 |
| recall +0.7/+0.1/+0.7pp | 관측된 산문/표 A/표 B 점추정 | 효과 0 또는 전역 무효과를 증명하지 않음 |
무엇을 측정한 것인가
- Consilience
지식그래프를 바탕으로 코딩·디자인·질의를 수행하는 범용 AI 에이전트입니다. 파견 엔지니어 없이 문서에서 온톨로지를 구축하고 관리합니다.