MuSiQue pooled-corpus 애블레이션: PPR 그래프 레그와 고정 융합 가중치의 한계
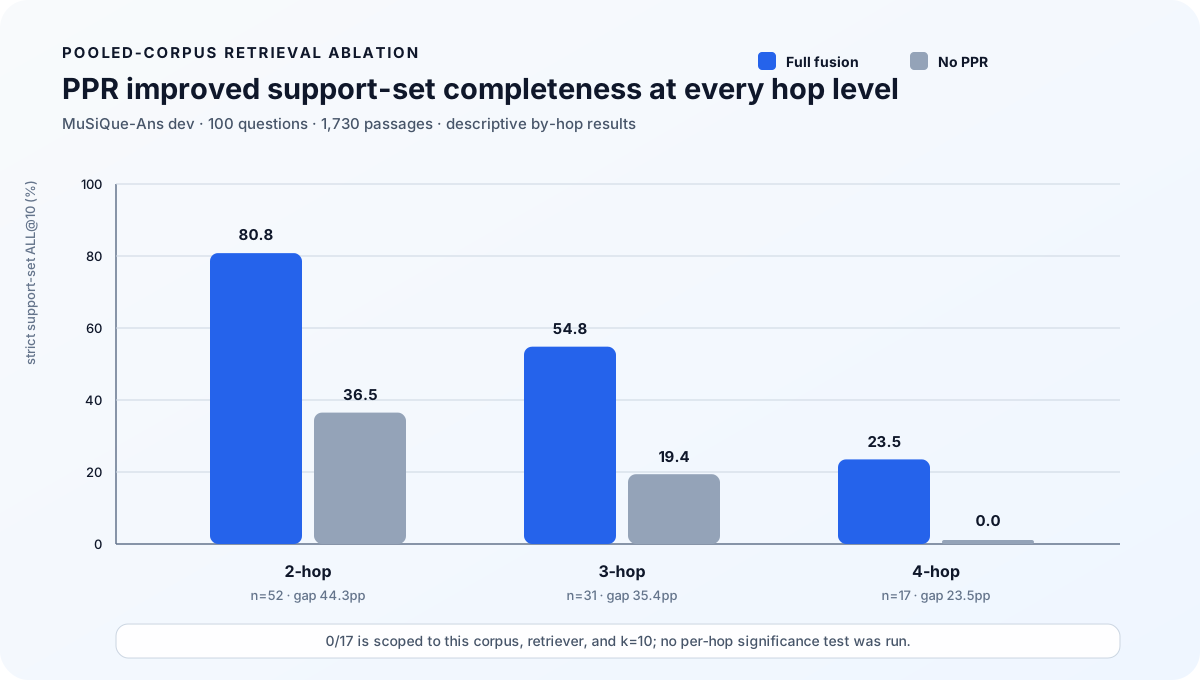
100문항·1,730문단의 내부 검색 파일럿에서 strict support-set ALL@10은 전체 융합 63%, PPR 제거 25%, 키워드 전용 23%였습니다. 4홉의 23.5% 대 0/17은 이 설정의 기술통계로 한정하고, 코퍼스에 따라 BM25 가중치의 방향이 뒤집힌 결과까지 보고합니다.
- ALL@10 · 전체 융합 vs PPR 제거 · n=100
- 63.0 vs 25.0
- 4홉 ALL@10 · n=17 · 홉별 유의성 검정 없음
- 23.5 vs 0.0
질문: 100문항·1,730문단 pooled MuSiQue 파일럿에서 PPR 그래프 레그는 근거 문단 회수에 얼마나 기여하며, 한 코퍼스에서 고른 융합 가중치를 실제 볼트에도 적용할 수 있는가?
관찰: strict support-set ALL@10은 전체 융합 63%, PPR 제거 25%, 키워드 전용 23%였다. 4홉에서는 23.5% 대 0/17이었지만, 절대 격차는 홉 수와 함께 커지지 않았고 reader 정답률도 측정하지 않았다.
결정: 그래프를 “멀티홉의 전제 조건”으로 일반화하지 않는다. PPR은 이 내부 비교에서 중요한 검색 레그로 유지하되, MuSiQue 스윕을 따라 실제 볼트의 BM25 가중치를 제거하지 않는다.
MuSiQue는 여러 문단을 연결해야 답할 수 있도록 만든 멀티홉 QA 벤치마크입니다. 이 연구는 최고 점수를 찾는 대회가 아니라, Consilience의 네 검색 레그 중 PPR 그래프 확산이 어떤 종류의 근거 회수에 값을 주는지 묻는 내부 애블레이션입니다.
1. 질문별 20문단이 아니라 하나의 pooled corpus
MuSiQue-Ans dev에서 고정 시드로 100문항을 층화 추출했습니다. dev 파일이 홉 유형 순으로 정렬돼 있어 앞의 100개를 그대로 가져오면 쉬운 2홉만 뽑히므로, 원 분포에 맞춰 2홉 52개, 3홉 31개, 4홉 17개를 고정했습니다.
각 질문의 문단을 합치고 중복을 제거해 1,730개 문단을 하나의 볼트로 만들었습니다. 모든 질문은 자신의 20개 문단 안이 아니라 이 전체 풀에서 검색합니다. 실제 앱 추출 경로로 1,727개 문서 그래프, 9,499개 엔티티, 63,492개 쿼드를 만들었고 임베딩 결손은 없었습니다. 그래프가 생기지 않은 3개 문단이 gold에 미친 영향은 별도로 확인하지 못했습니다.
두 지표를 분리했습니다.
- R@k: 질문별 근거 문단 중 top-k에 들어온 비율의 평균.
- ALL@k: 필요한 근거 문단이 전부 top-k에 들어온 질문의 비율.
ALL@10은 엄격한 근거 집합 완전성 지표이지, 답변 가능성이나 최종 정답률 그 자체가 아닙니다. reader EM/F1은 이 실행에서 측정하지 않았습니다.
2. PPR 레그를 제거하면 무엇이 사라지는가
질문, 코퍼스, 추출물과 평가 코드를 고정하고 융합 가중치만 바꿨습니다. 출하 구성은 lexical 0.1, BM25 1.0, PPR 1.0, semantic 0.05입니다.
| 검색 조건 | R@5 | R@10 | ALL@10 |
|---|---|---|---|
| 전체 융합 | 62.2% | 83.0% | 63.0% |
| PPR 제거 | 51.2% | 58.9% | 25.0% |
| lexical+BM25 전용 | 50.2% | 57.5% | 23.0% |
PPR 제거 대비 차이는 R@10 +24.1pp, ALL@10 +38.0pp입니다. 질문별 R@5에 적용한 paired sign test에서는 전체 융합이 29개 질문에서 높고 2개에서 낮았습니다(p=4.6e-7, n=100). 이 p값은 R@5의 대응 비교에만 해당하며 ALL@10이나 홉별 막대의 유의성을 말하지 않습니다.
이것은 “그래프가 어휘 신호 없이 답을 찾았다”는 결과도 아닙니다. PPR의 엔티티 시드는 어휘·의미 유사도에서 시작합니다. 관찰된 이득은 같은 초기 신호를 문서에 직접 매칭하는 데서 끝내지 않고, 엔티티와 문서 관계를 따라 확산한 뒤 노트 순위에 사용했을 때의 차이입니다.
3. 홉별 분해: 4홉 0/17의 올바른 해석
| 홉 | n | 전체 융합 ALL@10 | PPR 제거 | 절대 차이 |
|---|---|---|---|---|
| 2홉 | 52 | 80.8% | 36.5% | +44.3pp |
| 3홉 | 31 | 54.8% | 19.4% | +35.4pp |
| 4홉 | 17 | 23.5% | 0.0% | +23.5pp |
4홉 17개 중 PPR을 제거한 조건에서 모든 근거를 top 10에 넣은 질문은 없었습니다. 그러나 이 결과는 다음처럼 제한해서 읽어야 합니다.
- 두 조건 모두 홉이 늘수록 절대 성능이 하락합니다.
- 전체 융합과 PPR 제거의 절대 격차는 44.3→35.4→23.5pp로 줄어듭니다. “홉이 늘수록 격차가 커졌다”는 해석은 수치와 맞지 않습니다.
- 상대 비율로 보면 PPR 레그의 중요성이 커 보이지만, 4홉 표본은 n=17이고 홉별 검정은 하지 않았습니다.
- 0/17은 이 코퍼스·검색 구성·k=10에서의 관찰입니다. 그래프가 모든 4홉 검색의 논리적 전제라는 증거가 아닙니다.
가장 정확한 결론은 이 파일럿에서 PPR 레그가 모든 홉의 근거 완전성을 크게 높였고, 가장 어려운 4홉 슬라이스에서는 대조군의 성공을 관찰하지 못했다는 것입니다.
4. 더 높은 벤치마크 점수가 더 나은 출하 설정은 아니었다
같은 pooled corpus에서 PPR을 1.0으로 고정하고 45개 융합 구성을 탐색했습니다. 관측 최고 R@5는 78.1%였고 상위 6개가 모두 BM25=0이었습니다. 출하 구성은 61.9%였습니다. 그러나 이것은 탐색적 grid의 최댓값이며, 다중비교 보정이나 독립 확인이 없습니다.
더 중요한 반례는 실제 소유자 볼트에서 나왔습니다.
| 코퍼스 | BM25 1.0 | BM25 0 | 같은 파라미터의 효과 |
|---|---|---|---|
| Market fact lookup | 95.3% | 88.0% | +7.3pp |
| MuSiQue R@5 | 61.9% | 77.1% | −15.2pp |
MuSiQue의 방해 문단은 질문과 주제가 비슷하도록 의도적으로 구성돼 BM25에 어려운 분포일 수 있습니다. Market의 개인 문서는 같은 방식으로 적대적 선택되지 않았습니다. 이 메커니즘은 그럴듯하지만, 별도의 distractor-selection 개입으로 인과 검증한 것은 아닙니다.
따라서 벤치마크 최고 구성으로 출하 가중치를 바꾸지 않았습니다. 하나의 고정 가중치가 모든 코퍼스에 최적이라는 가설을 기각하고, query class와 corpus distribution에 따라 융합을 라우팅하는 후속 가설만 남겼습니다.
5. 실제 볼트에서의 전이 경계
동일한 출하 검색 경로를 두 실제 볼트의 fact-lookup 질문에서 대조했습니다.
| 볼트·질문 | 전체 융합 | PPR 제거 | 키워드 전용 |
|---|---|---|---|
| Market, n=150 | 90.7% | 78.7% | 60.0% |
| e2e, n=150 | 76.0% | 52.7% | 37.3% |
| e2e 교차언어, n=36 | 63.9% | 41.7% | 36.1% |
이 수치는 PPR 레그가 두 볼트에서 recall@10에 기여한다는 독립적인 제품 증거입니다. 그러나 두 볼트 모두 한 명의 소유자에게서 왔고 질문은 그래프에서 생성한 단일 사실 조회 중심입니다. 사용자 집단이나 멀티홉 작업 일반으로 확장할 수 없습니다.
표본 크기도 결론을 바꿨습니다. Market PPR 제거 효과는 n=40에서 −5pp, p=.25였지만 n=150에서 −12pp, p=4e-5였습니다. 작은 실행이 그럴듯한 위음성을 만들 수 있어, 이후 검색 애블레이션은 paired 표본과 불일치를 함께 보고합니다.
6. 한계와 다음 실험
- 공개 표준 설정보다 작은 100문항·1,730문단 풀이라 외부 절대 점수와 비교하지 않습니다.
- 45개 스윕의 최대치는 탐색 결과이며 독립 holdout이 없습니다.
- 근거 회수만 측정했고 최종 reader EM/F1, 인용 정확성, 지연과 그래프 구축 비용은 측정하지 않았습니다.
graph-ranking조건도 lexical/semantic entity seeding을 사용하므로 어휘 신호 없는 graph-only가 아닙니다.- 3개 문단의 그래프 추출 실패와 gold 영향이 분해되지 않았습니다.
- 다음 검증은 query-class router를 MuSiQue와 실제 볼트에 동시에 적용하고, 어느 한쪽만 이기는 설정은 기각해야 합니다.
재현성과 증거 경계
| 항목 | 보존 상태 |
|---|---|
| 측정 시점 | 2026년 7월 26일 |
| 표본 | MuSiQue-Ans dev 100문항, fixed-seed hop stratification; 2/3/4홉 = 52/31/17 |
| 코퍼스 | 고유 문단 1,730개, 실제 앱 추출 경로 |
| 하니스 | eval/musique_prep.py, qa_eval.rs::musique_multihop |
| paired 검정 | 질문별 R@5; full vs no-PPR 29승/2패, p=4.6e-7 |
| 원기록 | docs/details/musique-multihop-2026-07-26.md, retrieval-ablation-2026-07-26.md |
| 현재 주장 상태 | PPR의 내부 검색 기여는 유지; “그래프는 전제 조건”, “홉과 함께 격차 확대”, 외부 순위 주장은 철회 |
무엇을 측정한 것인가
- Consilience
지식그래프를 바탕으로 코딩·디자인·질의를 수행하는 범용 AI 에이전트입니다. 파견 엔지니어 없이 문서에서 온톨로지를 구축하고 관리합니다.