SWE-bench Verified 전수 실행: 394/500과 귀속의 한계
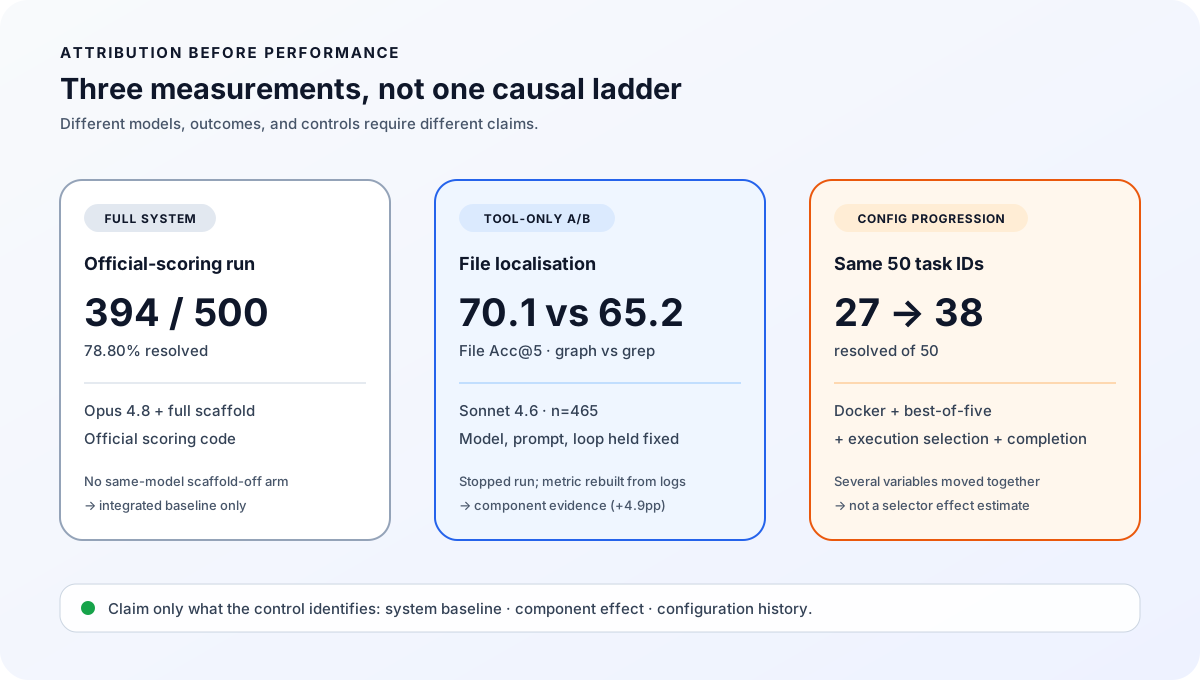
Opus 4.8과 전체 스캐폴드를 합친 시스템은 공식 채점 코드에서 394/500을 해결했습니다. 동일 모델의 scaffold-off 대조군이 없음을 먼저 밝히고, 별도의 Sonnet 4.6 도구 A/B에서 코드그래프 70.1% 대 grep 65.2% File Acc@5를 구성요소 증거로 분리합니다.
- 78.80% · 공식 채점 코드 · 모델+스캐폴드 통합 결과
- 394 / 500
- File Acc@5 · graph vs grep · Sonnet 4.6 · 중단 실행 n=465
- 70.1 vs 65.2
질문: 모델과 에이전트 스캐폴드를 합친 시스템은 SWE-bench Verified 500개에서 무엇을 해결했으며, 그중 어느 부분을 개별 구성요소의 효과로 귀속할 수 있는가?
관찰: 통합 시스템은 공식 채점 코드에서 394/500을 해결했다. 별도의 도구 A/B에서는 코드그래프가 grep보다 File Acc@5를 4.9pp 높였지만, 27/50→38/50 비교에는 실행 환경·후보 수·선택 절차·완주율이 함께 바뀌었다.
결정: 78.80%는 통합 시스템 결과로만 보고하고, 스캐폴드의 효과는 구성요소별 통제 실험에서만 주장한다. 중단·원자료 손실·벤치마크 오염 가능성도 결과와 같은 수준으로 공개한다.
SWE-bench Verified는 실제 GitHub 이슈와 저장소 상태를 재현하고, 생성된 패치가 공식 채점 테스트를 통과하는지 평가합니다. 이 기록의 핵심은 높은 숫자 하나가 아니라 시스템 결과와 구성요소의 인과 효과를 분리해 읽는 법입니다.
1. 전수 실행: 394/500은 통합 시스템의 결과다
2026년 6월, 500개 태스크 전체를 swebench 4.1.0 채점 경로로 실행했습니다. 모델은 Claude Opus 4.8이었고, 에이전트는 어휘·밀집·코드그래프 검색, Docker 재현, 수정, 재검증, 후보 5개와 실행 기반 선택을 사용했습니다.
| 결과 | 태스크 | 해석 |
|---|---|---|
| 해결 | 394 / 500 (78.80%) | 모델과 스캐폴드를 합친 통합 결과 |
| 미해결 | 106 / 500 | 빈 패치 5개 포함 |
| 미채점 | 0 / 500 | 최종 집계에서 누락 없음 |
저장소별 차이도 컸습니다. scikit-learn은 30/32, xarray는 20/22였지만 pylint는 4/10이었습니다. Django 231개가 전체의 46%를 차지하므로, 단일 평균은 저장소 구성의 영향을 강하게 받습니다.
가장 중요한 귀속 경계는 명확합니다. 동일한 500개에서 Opus 4.8을 스캐폴드 없이 실행한 대조군이 없습니다. 따라서 394개 중 몇 개를 모델이, 몇 개를 검색이나 실행 선택이 만들었는지 이 실행만으로 분해할 수 없습니다. 78.80%를 “스캐폴드 점수”나 “스캐폴드가 만든 향상”으로 부르지 않습니다.
2. 구성요소 증거: 검색 도구만 바꾼 A/B
코드그래프의 기여는 별도 로컬라이제이션 실험에서 분리했습니다. Claude Sonnet 4.6, 프롬프트, 에이전트 루프와 태스크 조건을 고정하고 에이전트에 노출하는 검색 도구만 graph와 grep으로 바꿨습니다. 지표는 해결률이 아니라 수정 대상 파일이 상위 5개 안에 포함되는 비율(File Acc@5)입니다.
| 조건 | File Acc@5 | 범위 |
|---|---|---|
| grep 도구 | 65.2% | SWE-bench Verified, n=465 |
| 코드그래프 도구 | 70.1% | 동일 실행, n=465 |
| 차이 | +4.9pp | 신뢰구간·대응검정 미보존 |
이 비교는 구성요소 귀속에 가장 가까운 증거이지만 완결된 벤치마크는 아닙니다. 계획한 500개 중 465개에서 실행이 중단됐고, File Acc@5만 로그에서 복원했습니다. 원시 465쌍과 @1·@10·함수 단위 지표는 남아 있지 않습니다. 더 쉬운 SWE-bench Lite에서는 +1.1pp(n=272), 비무작위 prefix 102개인 LocBench에서는 동률이었습니다. LocBench Security 5개에서는 graph가 grep보다 낮았으므로 “모든 슬라이스에서 무손실”이라고도 주장하지 않습니다.
결론은 제한적입니다. 이 하니스에서 그래프 도구는 Verified 파일 로컬라이제이션을 4.9pp 높였고, 다른 두 데이터셋에서는 작거나 없는 이득을 보였습니다. 패치 정답률이나 일반적인 코드 이해 능력까지 증명한 것은 아닙니다.
3. 27/50→38/50은 선택기 단독 A/B가 아니다
같은 50개 태스크 ID를 사용한 두 보존 산출물은 해결 수가 27개에서 38개로 늘어난 과정을 보여줍니다. 그러나 이 비교에서 함께 달라진 것이 여러 개입니다.
| 보존 산출물 | 해결 | 완료 / 빈 패치 | 함께 달라진 구성 |
|---|---|---|---|
| no-Docker graph agent | 27/50 | 35 / 15 | 단일 생성에 가까운 경로, 실행 선택 없음 |
| Docker exec-select | 38/50 | 50 / 0 | live Docker 재현, best-of-5, 교차 실행 선택 |
기계 판독 가능한 산출물이 확인하는 고정값은 동일한 50개 태스크 ID입니다. 모델·프롬프트 플래그는 두 JSON에 남아 있지 않습니다. 실행 환경, 후보 생성 기회, 선택 절차와 완주율이 함께 변했으므로 +22pp를 실행 선택기의 인과 효과로 귀속할 수 없습니다. 이 수치는 제품 구성의 진전이지 단일 변수 애블레이션이 아닙니다.
이 정정은 결과를 약하게 만들지 않습니다. 오히려 어떤 증거가 아키텍처 전체를 평가하고, 어떤 증거가 구성요소를 평가하며, 어떤 비교는 아직 분해되지 않았는지를 명확히 합니다.
4. 500개를 끝내게 만든 것은 체크포인트 설계였다
첫 전수 실행은 476/500 지점에서 외부 SIGKILL로 중단됐습니다. 예측을 저장소 단위로만 체크포인트했기 때문에 Django 231개 묶음의 인메모리 패치 약 207개가 사라졌고, 집계 보고서 기준 약 27시간·$700의 연산을 잃었습니다.
수정은 성능 튜닝이 아니라 실패 복구 설계였습니다.
- 체크포인트 단위를 저장소에서 인스턴스로 내리고, 패치가 생성되는 즉시 기록했습니다.
- 하나의 저장소를 여러 프로세스로 나눌 수 있게 해 재실행 범위를 줄였습니다.
- 채점 이미지를 미리 받고 네트워크 단절에 재시도를 두어, 테스트 실행을 외부 네트워크와 분리했습니다.
- Django 재실행은 약 6시간, 오류 0건으로 끝났습니다.
장시간 에이전트 평가에서 체크포인트는 운영 편의가 아니라 측정의 일부입니다. 실패한 실행이 특정 저장소의 결과를 선택적으로 지우면 최종 평균도 바뀌기 때문입니다.
5. 벤치마크의 유효성 경계
SWE-bench Verified 자체도 더 이상 안정적인 최종 척도로 볼 수 없습니다. OpenAI는 2026년 2월 Verified 결과의 공개 보고를 중단하며, 감사한 어려운 138개 중 59.4%에서 불완전한 명세나 결함 있는 테스트를 확인했고 여러 프런티어 모델에서 오염 정황을 보고했습니다.
따라서 78.80%는 2026년 6월 당시 공개 스위트와 공식 채점 코드에 대한 역사적 통합 결과입니다. 현재의 일반적 소프트웨어 엔지니어링 능력이나 인간 정답률과 같은 의미로 읽지 않습니다. 원본 SWE-bench가 실제 저장소 이슈를 실행 가능한 평가로 만든 공헌은 여전히 크지만, 포화된 단일 점수를 제품의 핵심 주장으로 삼지 않습니다.
실제로 유지할 결정은 두 가지입니다.
- 코드그래프는 파일 로컬라이제이션 도구로 유지하되, +4.9pp의 범위를 넘겨 주장하지 않습니다.
- 통합 해결률은 회귀 기준선으로 보관하고, 후속 평가는 오염 가능성이 낮은 대표 태스크와 구성요소별 eval로 이동합니다.
6. 한계
- 동일 모델의 scaffold-off 전수 대조군이 없어 394/500의 원인을 분해할 수 없습니다.
- 전수 실행의 원시 prediction·scorer bundle은 현재 저장소에서 확인되지 않고 집계 보고서만 남아 있습니다.
- graph-vs-grep 실행은 n=465에서 중단됐고, 원시 paired 로그와 불확실성 추정이 보존되지 않았습니다.
- 50개 비교는 태스크만 동일하며 여러 시스템 변수가 함께 바뀌었습니다.
- 저장소별 표본과 난도가 불균형하고, 외부 벤치마크의 오염과 결함이 확인됐습니다.
- 비용 약 $1,800–1,900은 집계 보고서의 추정이며, 완전한 호출별 원장은 보존되지 않았습니다.
재현성과 증거 경계
| 항목 | 보존 상태 |
|---|---|
| 측정 시점 | 2026년 6월 |
| 전수 실행 | docs/archive/verified-500-report.md; 500개 집계와 저장소별 결과 |
| 검색 도구 A/B | docs/code-graph-eval/benchmark-paper.md; n=465 로그 복원 집계 |
| 50개 구성 비교 | coh_nodocker_50.json, coh_execsel_50.json; 동일 ID와 결과는 보존, 모델·프롬프트 플래그는 미보존 |
| 하니스 | src-tauri/src/code_graph/eval_live.rs, eval_bench.rs |
| 현재 주장 상태 | 전수 결과는 통합 시스템 기준선, graph-vs-grep만 구성요소 증거, 27→38은 비인과적 구성 비교 |
| 비트 단위 재현 | 불가. 원시 전수 예측, n=465 paired 로그와 당시 외부 모델 상태가 완전하게 보존되지 않음 |
무엇을 측정한 것인가
- Consilience
지식그래프를 바탕으로 코딩·디자인·질의를 수행하는 범용 AI 에이전트입니다. 파견 엔지니어 없이 문서에서 온톨로지를 구축하고 관리합니다.